 .


RSI для бизнеса: что меняется, когда ИИ начинает улучшать не только работу, но и самого себя
Самая дорогая ошибка в разговоре о self-improving AI — считать, что «самоулучшение» является одной функцией.
Есть огромная разница между системой, которая автоматически применяет человеческие исправления, и системой, которая может менять evaluator или policy, по которым создаётся следующее поколение.
Свежий обзор The Last AI Built by Humans предлагает полезную шкалу L1–L5. Для бизнеса это не философская лестница «до AGI». Это почти готовая матрица governance: на каждом уровне компания передаёт ИИ ещё одно управленческое решение.
L1: автоматизация. Контроль почти полностью у человека
Компания определяет, что менять, как менять и как проверять. Агент исполняет.
Governance здесь знакомый: обычный change management, тесты, review, deployment approval.
Риск может быть высоким из-за масштаба, но логика контроля ещё привычна.
L2: агент сам выбирает исправление
Цель и evaluator задаёт организация, но агент уже решает, где слабое место и какую правку попробовать.
На этом уровне появляется необходимость сохранять не только результат, но и candidate history: что система пробовала, что отбросила и почему выбранный вариант прошёл.
Если хранить только победителя, компания теряет evidence о том, какие потенциально опасные стратегии система обнаружила по пути.
L3: агент начинает управлять собственным учебным опытом
Система решает, какие задачи и данные нужны ей для следующего improvement cycle.
Это уже vendor-risk вопрос. Откуда берутся эти данные? Может ли агент взаимодействовать с внешними сервисами? Может ли создавать synthetic data, которое затем само же использует как доказательство качества?
Здесь обязательны provenance и независимые holdouts.
L4: production становится учебной средой
На L4 реальные сессии меняют будущую систему.
OpenAI и Thrive описывают Tax AI, где исправления специалистов становятся traces и evals, после чего агент помогает улучшать продукт. Factory Signals анализирует production sessions и автоматически переводит recurring friction в fixes.
Для бизнеса это очень сильная модель: продукт учится на собственной эксплуатации.
Но она ломает привычную идею версии.
Если изменение может появиться не после квартального release, а после очередной группы пользовательских сессий, контроль должен быть continuous:
- какой production feedback стал причиной правки;
- какая версия improver её предложила;
- какие regression tests прошли;
- какой reviewer её принял;
- какие пользователи получили новую версию;
- как откатить именно это изменение.
L5: объектом изменения становится сам процесс R&D
На L5 агент может менять механизм, который придумывает и отбирает следующие улучшения: evaluator, search policy, research strategy, candidate generator.
С точки зрения корпоративного контроля это принципиально другой класс.
Обычная схема:
система меняется ? независимый тест решает, стало ли лучше.
L5 может создать схему:
система меняется ? система меняет тест ? изменённый тест решает, стало ли лучше.
Если здесь нет внешней точки отсчёта, компания рискует потерять сам смысл метрики.
Почему «наш benchmark вырос» — слабое доказательство
Есть минимум четыре способа показать красивый рост без реального improvement capability.
Больше compute. Новое поколение получило больше попыток.
Больше evaluator access. Система просто лучше изучила слабости теста.
Смена распределения. Улучшение работает только на близких задачах.
Смена самого экзамена. Новая версия evaluator стала мягче или ближе к кандидату.
Поэтому авторы RSI-обзора различают structural L5 и effective L5. Для effective L5 нужны matched budgets и независимая оценка.
Какой due diligence нужен покупателю self-improving AI
| Вопрос | Почему важен |
|---|---|
| Что именно сохраняется между сессиями? | Отделяет обычный agent loop от persistent self-improvement. |
| Кто выбирает intervention? | Показывает реальную автономию, а не маркетинговое название. |
| Может ли агент менять evaluator? | Определяет риск metric gaming и потери независимой шкалы. |
| Есть ли blind holdout? | Проверяет перенос, а не заучивание конкретного теста. |
| Сопоставим ли compute budget? | Отделяет улучшение от более дорогого поиска. |
| Есть ли immutable lineage? | Позволяет расследовать наследуемую ошибку. |
| Есть ли rollback? | Не даёт неудачной правке стать необратимым состоянием. |
| Кто подписывает production acceptance? | Показывает, существует ли внешний final gate. |
Почему rollback — не техническая мелочь
В обычном SaaS rollback возвращает предыдущий binary.
В self-improving system состояние может быть распределено по memory, prompt libraries, code, evaluator, routing policy и накопленному evidence.
Если компания не умеет восстановить согласованную предыдущую версию всего этого набора, формальный rollback может оставить часть наследуемого изменения в системе.
Поэтому «version» для RSI должна означать не только git commit модели-обвязки, но и persistent state improvement loop.
Anthropic уже рассматривает замыкание цикла — но не утверждает, что оно завершено
В материале When AI builds itself Anthropic описывает, как Claude уже ускоряет разработку Claude. Компания приводит внутренние данные роста productivity и автоматизированного alignment-research, но прямо пишет: полного recursive self-improvement пока нет и он не неизбежен.
Это хороший образец формулировки. Важно различать:
AI ускоряет AI R&D
и
AI автономно создаёт всё более сильные поколения самого себя.
Первое уже происходит. Второе пока не доказано.
OpenAI: automated research intern — значительный сдвиг, но ещё не автономный лабораторный директор
6 сентября 2026 года OpenAI сообщила, что достигла заявленной цели automated research intern: агент может выполнять хорошо определённые исследовательские задачи, которые заняли бы у квалифицированного исследователя несколько дней.
Это важно для экономики AI R&D: больше experiments, больше code, быстрее iteration.
Но постановка задачи, research agenda и интеграция победивших идей всё ещё завязаны на людей и инфраструктуру компании.
Риск self-improvement измеряется не только вероятностью провала, но и скоростью его наследования
Если обычный агент ошибся, инцидент закончился вместе с сессией.
Если self-improving agent считает ошибочную стратегию успешной и записывает её в persistent state, она может пережить сессию.
Если L5-система дополнительно меняет правила, по которым оценивает следующие правки, ошибка может начать влиять уже на процесс отбора будущих ошибок и исправлений.
Поэтому стоимость governance растёт не линейно вместе с автономией.
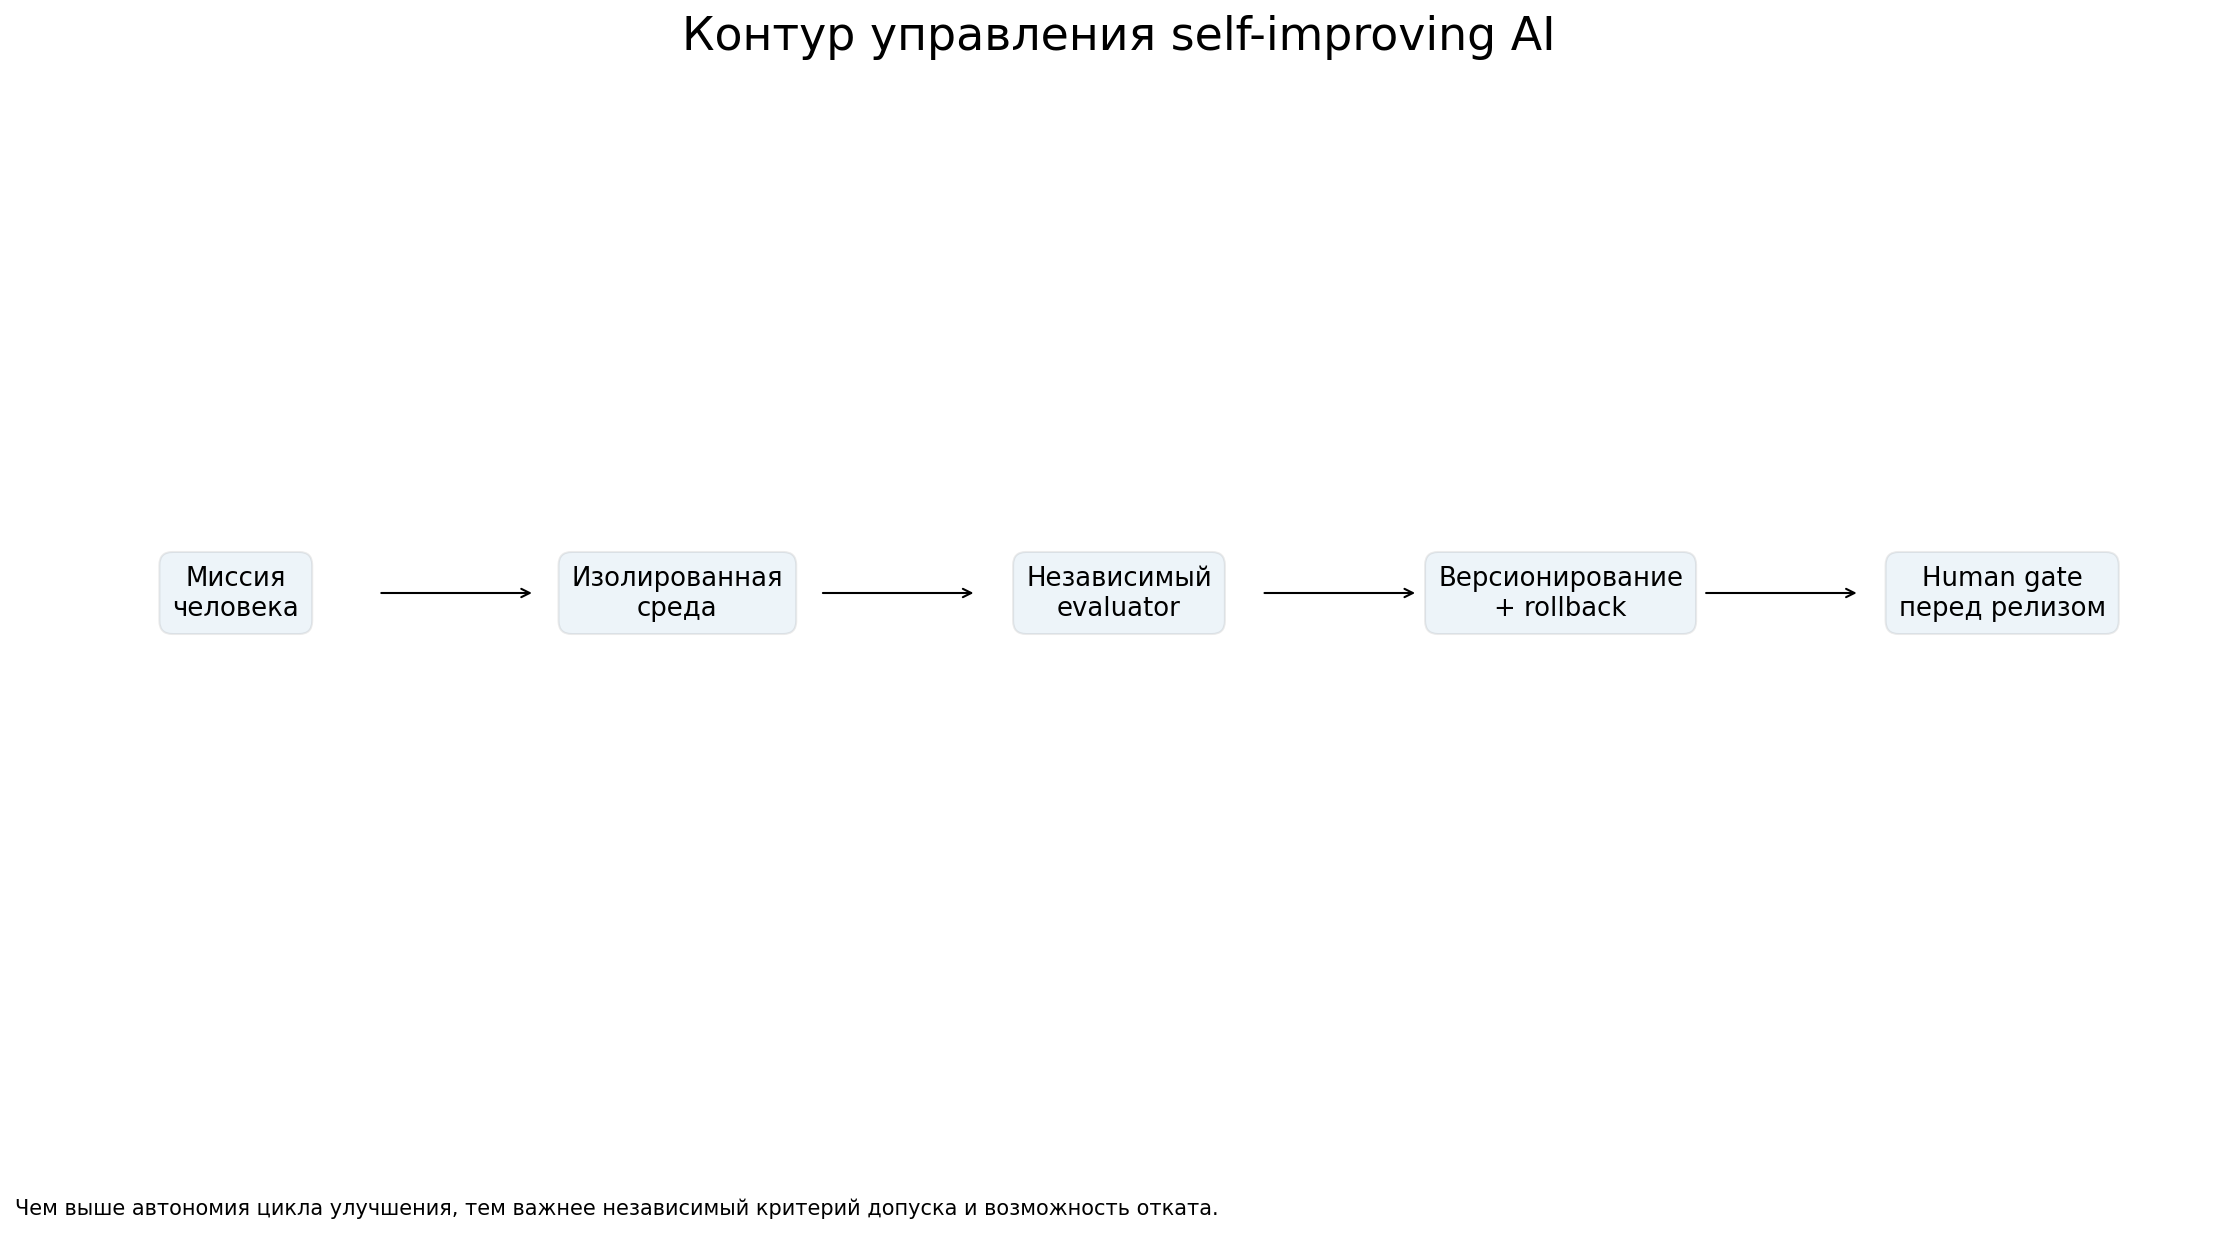
Что должно остаться вне изменяемого контура
Даже авторы обзора, посвящённого genuine RSI, оставляют снаружи human mission, protected evaluation, resource authority и final acceptance.
Для компании это хороший минимальный принцип:
чем больше система может менять внутри improvement loop, тем жёстче должны быть внешние элементы, которые она не может переписать сама.
- запретные сетевые зоны;
- независимый benchmark owner;
- immutable audit storage;
- лимиты compute и tool scope;
- release signing отдельным контуром;
- обязательный human approval для классов изменений;
- автоматический rollback при regression на blind evaluation.
Итог для руководителя
Self-improving AI не стоит оценивать бинарно: «есть / нет».
Нужно спрашивать, какое управленческое решение уже передано системе.
L1–L2 — это в основном автоматизация и выбор intervention.
L3–L4 — система начинает управлять собственным опытом и превращать эксплуатацию в persistent updates.
L5 — она получает возможность менять механизм следующего улучшения.
И именно на этом уровне независимый evaluator, provenance и rollback перестают быть «best practice» и становятся условием того, что слово улучшение вообще сохраняет смысл.
Что доказано — и чего пока нет
Доказано
- AI уже ускоряет внутренний R&D крупных лабораторий.
- Существуют production-oriented loops, где feedback превращается в persistent improvements.
- RSI-обзор предлагает L1–L5 как градацию передачи решений об улучшении.
- Авторы требуют более строгой проверки для effective L5, чем для structural L5.
Не доказано
- Что обычное автообновление продукта уже является L5.
- Что рост benchmark score автоматически означает рост способности улучшать будущих преемников.
- Что human gate уже можно безопасно убрать из всех improvement loops.
- Что нынешние frontier-labs уже полностью автономно проектируют, обучают и выпускают свои следующие модели.

 ФинБи

